ID 해싱을 통한 저장 용량 및 성능 최적화
개요
-통상적, 편의상으로 데이터들의 ID는 문자열값으로 부여함
-리플레이 시스템 구현을 위해서 해당 개체의 베이스 데이터 ID값을 저장해둬야함. 그래야 로드 시 해당 개체가 존재하지 않을때 DB에서 데이터를 찾아와 인스턴싱 가능
-하지만 문자열을 SaveData로 하면 byte[]로 변환할때 많은 용량을 사용하고 성능도 좋지 않음
-따라서 DB딴에서 처음부터 데이터들의 ID값을 정수-문자열 쌍으로 해싱(해시함수도 없는 그냥 1대1 대응이지만)하여 저장 및 로드시 상호 변환하여 이용
구현
-정수 ID타입은 ushort를 사용함. int보다 사용 byte가 작고 6만 정도로 이정도 게임 데이터 인덱싱에는 충분한 값까지 사용 가능
-구현의 용이성을 위해 정수 ID를 넣으면 문자열 ID를, 문자열 ID를 넣으면 정수 ID를 반환하는 양방향 딕셔너리를 구현
-인스펙터에서 List로 SOData를 직렬화하고 이를 런타임에서 딕셔너리로 변환. 키는 ushort로 둠
-해당 DataDB를 제네릭화해 파생 DB를 작성
-개체 생성 시 개체 ID를 string으로 지정. 개체 저장 시 ID를 ushort로 변환
성능 실험
-문자열 ID를 그대로 저장한 경우와 ushort로 변환해 저장한 경우에 연산 및 GC.Alloc 크기를 체크
-정확한 비교를 위해 같은 조건, 같은 프레임에서 프로파일링 결과 확인
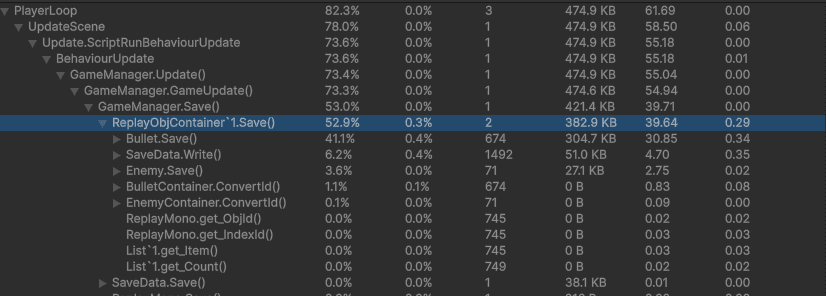
문자열 ID
-약 500KB의 할당 발생
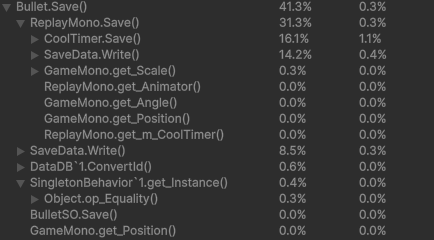
-문자열 ID 파트 스택에서 발생한 할당은 약 130KB (ReplayObjContainer -> SaveData.Save, SaveData.Write)
-해당 SaveData.Write의 연산량 전체의 11%
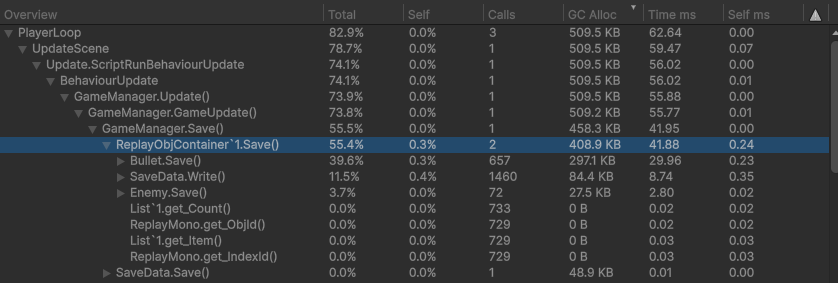
정수형 Id
-약 470KB의 할당 발생
-ID 파트 스택에서 발생한 할당은 약 90KB (ReplayObjContainer -> SaveData.Save, SaveData.Write)
-해당 SaveData.Write의 연산량 전체의 6%
결과
-ID 저장 파트에 한하여 30% 정도의 용량 압축, 50% 정도의 연산량 감소 효과
-Save 전체 영역에서 보면 5~8% 정도의 용량압축 및 연산량 감소 효과가 있음
-ID를 변환하는 비용이 약간 발생하나 저장 용량 및 연산량 감소 효과에 비하면 훨씬 미미함
-문자열은 가능한 저장하지 않기